ÖZET Bu makale, ETVZ (Etik Temelli Vicdani Zeka) çerçevesini Pekiştirmeli Öğrenme (Reinforcement Learning — RL) paradigması üzerinden teknik olarak ele almaktadır. HVM, DERP, DERMS ve Epistemic Memory modülleri; bir RL ajanının ödül sinyali, eylem uzayı, durum temsili ve politika güncellemesi katmanlarına eşlenmektedir. V_morality formülünün negatif ödül fonksiyonu olarak, DERP’in ΔP formülünün politika gradyanı olarak işlev gördüğü gösterilmektedir. Makale ayrıca sözde kod tabanlı algoritma tanımları, ASCII mimari şemalar ve sistematik bir simülasyon test metodolojisi içermektedir. Anahtar Kelimeler: Pekiştirmeli Öğrenme, Etik AI, RLHF, ETVZ, HVM, CMDP, Güvenli RL, Simülasyon Testi, Ödül Şekillendirme
1. Giriş ve Motivasyon
Büyük Dil Modelleri ve otonom karar sistemleri, giderek daha yüksek riskli ortamlarda görev almaktadır. Bu sistemlerin etik olarak hizalanmış kalması, statik kural setleriyle sağlanamaz; dinamik, öğrenen ve bağlama duyarlı mekanizmalar gerektirir.
ETVZ, bu ihtiyaca yanıt veren özgün bir çerçevedir. Temel iddiası şudur: Bir yapay zeka sistemi, yalnızca davranışsal kısıtlama ile değil; içsel etik muhakeme kapasitesi kazandırılarak güvenilir hale getirilebilir. Bu yaklaşım, RLHF’in (İnsan Geri Bildiriminden Pekiştirmeli Öğrenme) ötesine geçmektedir. RLHF, insan tercihlerini ödül sinyaline dönüştürür; ancak bu tercihler tutarsız, önyargılı veya bağlam dışı olabilir. ETVZ ise etik değerlendirmeyi formüle edilmiş, ölçülebilir ve güncellenebilir bir iç modele taşır.
Bu makale şu soruları yanıtlamaktadır:
ETVZ bileşenleri RL terminolojisine nasıl eşlenir?
V_morality formülü bir ödül fonksiyonu olarak nasıl modellenir?
DERP’in ΔP formülü politika gradyanı olarak nasıl çalışır?
HITL mekanizması güvenli keşif kısıtlaması olarak nasıl konumlandırılır?
Önerilen mimari nasıl sistematik olarak test edilir?
2. ETVZ Mimarisine Genel Bakış
ETVZ dört ana modülden oluşmaktadır. Bu modüller birbirleriyle sürekli etkileşim halindedir ve birlikte iki farklı zaman ölçeğinde çalışan bir kontrol sistemi oluştururlar: milisaniye düzeyinde anlık etik filtreleme ve haftalık politika güncelleme döngüsü.
Modül
Tam Adı
RL Karşılığı
HVM
Hesaplamalı Vicdan Modülü
Ödül Fonksiyonu + Eylem Filtresi
DERP
Derin Etik Düzenleme Protokolü
Politika Güncelleme (ΔP → ∇θ)
DERMS
Dinamik Etik Risk İzleme Sistemi
Ortam Gözlemcisi + Drift Tespiti
Epistemic Memory
Neo4j Etik Bilgi Grafiği
Durum Temsili + Deneyim Tamponu
2.1 Sistem Mimarisi Şeması
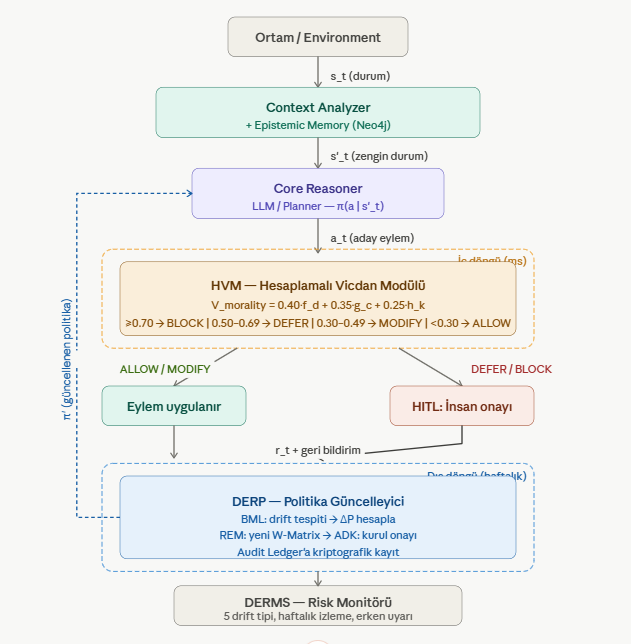
Aşağıdaki şema, ETVZ-RL sisteminin bileşenlerini, veri akışını ve iç/dış döngü ayrımını göstermektedir:
📐 Katmanlı Kontrol Prensibiİç döngü (HVM, milisaniyeler): Her eylem üretildiğinde anlık etik değerlendirme — ajanın dış dünyayla temas etmeden önce geçmesi gereken filtredir. Dış döngü (DERP, haftalar): İstatistiksel drift analizine dayalı politika güncelleme — toplumsal normların evrimiyle birlikte sistemin adapte olmasını sağlar.
2.2 HVM: Hesaplamalı Vicdan Modülü
HVM, her aday eylemin dış dünyaya yansımadan önce etik süzgeçten geçirildiği merkezi filtre katmanıdır. Üç bağımsız alt model, ağırlıklı toplam aracılığıyla bütünleşik bir etik risk skoru (V_morality) üretir.
V_morality(a) = 0.40 × f_deontic(a) + 0.35 × g_consequential(a) + 0.25 × h_culture(a)HVM Ana Formülü — V_morality ∈ [0,1] | 0 = Tamamen Etik, 1 = Tamamen Etik Dışı
Karar eşiği tablosu:
V_morality Aralığı
Karar
Açıklama
≥ 0.70
BLOCK
Eylem kesinlikle engellenir, sonsuz negatif ödül
0.50 – 0.69
DEFER
İnsan onayına ertelenir (HITL tetiklenir)
0.30 – 0.49
MODIFY
Eylem kısmi düzeltmeyle serbest bırakılır
< 0.30
ALLOW
Eylem doğrudan uygulanır
2.3 DERP: Derin Etik Düzenleme Protokolü
DERP, HVM’in ağırlık matrisini (W-Matrix) dinamik olarak güncelleyen üst-koordinatör katmandır. Temel sorusu şudur: etik sapma tespit edildiyse, politikayı ne kadar ve nasıl değiştirmeliyiz?
DERP dört katmandan oluşmaktadır: (1) Politika Yönetim Katmanı (PYK) — mevcut ağırlıkları korur ve versiyon yönetimini sağlar; (2) Davranışsal İzleme Katmanı (BML) — istatistiksel drift testleri yürütür; (3) Düzenleme Motor Katmanı (REM) — ΔP formülünü hesaplayarak yeni ağırlıkları önerir; (4) Denetim ve Karar Katmanı (ADK) — Etik Kurul onayını alır ve değişikliği Audit Ledger’a imzalı olarak kaydeder.
3. ETVZ’yi RL Olarak Modellemek: Teorik Çerçeve
Pekiştirmeli öğrenme, bir ajanın çevre ile etkileşerek birikimli ödülü maksimize etmeye çalıştığı öğrenme paradigmasıdır. Matematiksel olarak Markov Karar Süreci (MDP) ile temsil edilir: (S, A, P, R, γ). ETVZ bu çerçeveye etik kısıt katmanı olarak eklenir.
RL Bileşeni
ETVZ Karşılığı
Açıklama
Durum s ∈ S
Context = {niyet, domain, kültür, geçmiş}
Epistemic Memory üretir
Eylem a ∈ A
Aday çıktı (metin, karar, tavsiye)
Core Reasoner üretir
Ödül R(s,a)
-V_morality(a) + α·Usefulness(a)
HVM çıktısının negatifi
Politika π(a|s)
W-Matrix (w_deontic, w_conseq, w_culture)
DERP günceller
Geçiş P(s’|s,a)
Çevrenin ETVZ kararına yanıtı
Audit Log + Feedback
Kısıt C(s,a) ≤ 0
Hard Constraints (insan hayatı, temel haklar)
Sıfır tolerans
Deneyim Tamponu
Epistemic Memory — Neo4j grafiği
Geçmiş kararlar
Erken Durdurma
HITL — V_morality > 0.70 veya belirsizlik > 0.40
İnsan devreye girer
3.1 Kısıtlı MDP (CMDP) Olarak ETVZ
Standart RL kısıtsız ödül maksimizasyonuna yönelir. ETVZ ise hard kısıtları asla ihlal edemeyeceğinden doğru çerçeve Kısıtlı Markov Karar Süreci (CMDP)’dir:
Ağırlık dengesi kritiktir: aşırı yüksek λ_ethics, ajanın pasif kalmasına (sürekli BLOCK) neden olur; aşırı düşük ise etik kısıtların devre dışı kalması anlamına gelir.
4. Temel Algoritmalar — Sözde Kod
4.1 HVM Etik Filtreleme Algoritması
// HVM_FILTER(action a, context s) → (decision, reward)INPUT: a — aday eylem s — bağlam vektörü (niyet, domain, kültür) // ── Adım 1: Üç alt filtreden skor al ────────────────────── SET f_deontic ← DeonticModel.score(a, s)SET g_consequential ← ConsequentialModel.score(a, s)SET h_culture ← CultureModel.score(a, s.region) // ── Adım 2: V_morality hesapla ──────────────────────────── SET V ← 0.40 × f_deontic + 0.35 × g_consequential + 0.25 × h_cultureSET V ← CLAMP(V, 0.0, 1.0) // ── Adım 3: Karar eşiği değerlendirme ──────────────────── IF V >= 0.70 THENSET reward ← NEGATIVE_INFINITY // hard kısıt ihlaliRETURN (BLOCK, reward)ELIF V >= 0.50 THENSET human_decision ← HITL.request(a, V)IF human_decision == APPROVE THENSET reward ← -V + 0.70 × Usefulness(a)RETURN (DEFER_APPROVED, reward)ELSERETURN (DEFER_REJECTED, -0.30)END IFELIF V >= 0.30 THENSET a_modified ← Modifier.adjust(a, V)SET reward ← -V + 0.30 × Usefulness(a_modified)RETURN (MODIFY, reward)ELSESET reward ← 0.50 × (-V) + 0.30 × Usefulness(a)RETURN (ALLOW, reward)END IF
4.2 DERP Politika Güncelleme Algoritması
// DERP_UPDATE(violation_log, culture_factor, user_feedback) → ΔPINPUT: violation_log — haftalık ihlal kayıtları {(Eᵢ, Wᵢ)} listesi culture_factor — kültürel norm katsayısı F_culture ∈ [0,1] user_feedback — normalize kullanıcı memnuniyeti U_user ∈ [-1,1] // ── Adım 1: BML — İstatistiksel drift testi ─────────────── FOR each drift_type IN [INCONSISTENCY, BIAS, OVERSENSOR, PERF, CULTURAL]:CALL BML.run_statistical_test(drift_type, violation_log)IF test.p_value < 0.05 THENSET drift_detected[drift_type] ← TRUEEND IFEND FOR // ── Adım 2: REM — ΔP hesapla ────────────────────────────── SET weighted_sum ← Σ (Eᵢ × Wᵢ) FOR ALL i IN violation_logSET n ← LENGTH(violation_log)SET delta_p ← (0.50 × weighted_sum/n) + (0.30 × culture_factor) + (0.20 × user_feedback) // ── Adım 3: Değişim sınırı uygula ──────────────────────── SET MAX_DELTA ← 0.25 // haftalık maksimum politika değişimiSET delta_p ← CLAMP(delta_p, -MAX_DELTA, +MAX_DELTA) // ── Adım 4: ADK — Etik Kurul onayı ────────────────────── SET proposal ← {delta_p, drift_detected, timestamp}IF EthicsBoard.approve(proposal) THENCALL W_Matrix.update(delta_p)CALL AuditLedger.sign_and_record(proposal) // kriptografik imzaRETURN delta_pELSERETURN 0.0 // değişiklik reddedildi, politika korunduEND IF
4.3 PPO-Lagrangian Eğitim Döngüsü (Ana RL Döngüsü)
// PPO_LAGRANGIAN_TRAIN(env, policy_π, hvm, derp, epochs)INPUT: env — ETVZ Safety Wrapper ile sarmalanmış ortam policy_π — Core Reasoner’ın politikası (W-Matrix dahil) hvm — HVM ödül fonksiyonu derp — DERP politika güncelleyici epochs — toplam eğitim döngü sayısı // ── Başlangıç ───────────────────────────────────────────── SET lambda_constraint ← 0.01 // Lagrange çarpanı (adaptif)SET buffer ← EpistemicMemory() // deneyim tamponuFOR epoch = 1 TO epochs DO: // ── Trajektori toplama ──────────────────────────────── FOR step = 1 TO T DO:SET s_t ← env.observe() + ContextAnalyzer.enrich()SET a_t ← policy_π.sample(s_t) // aday eylemSET (dec, r_t) ← HVM_FILTER(a_t, s_t) // etik filtreSET s_t1 ← env.step(a_t IF dec != BLOCK ELSE None)CALL buffer.store(s_t, a_t, r_t, s_t1, dec)END FOR // ── PPO-Lagrangian politika güncellemesi ────────────── SET batch ← buffer.sample(BATCH_SIZE)SET L_clip ← PPO.clipped_objective(batch, policy_π)SET constraint_viol ← batch.hard_violation_count / BATCH_SIZESET L_total ← L_clip – lambda_constraint × constraint_violCALL optimizer.step(∇ L_total) // ── Lagrange çarpanını güncelle ─────────────────────── IF constraint_viol > 0 THENSET lambda_constraint ← lambda_constraint × 1.05 // artırELSESET lambda_constraint ← lambda_constraint × 0.99 // azaltEND IF // ── DERP dış döngüsü (haftalık) ────────────────────── IF epoch MOD DERP_UPDATE_FREQ == 0 THENSET delta_p ← DERP_UPDATE(buffer.violation_log(), CultureModel.factor(), UserFeedback.score()) CALL policy_π.apply_delta(delta_p)END IFEND FORRETURN policy_π // eğitilmiş, etik kısıtlı politika
4.4 HITL Güvenlik Sarmalayıcısı
// ETVZ_SAFETY_WRAPPER.step(action, ethical_scores) → (obs, reward, done)INPUT: action — ajan tarafından önerilen eylem ethical_scores — (f_deontic, g_consequential, h_culture) üçlüsü SET (decision, reward) ← HVM_FILTER(action, ethical_scores)IF decision == BLOCK THEN // Hard kısıt: eylem uygulanmaz, sonsuz negatif ceza RETURN (env.current_obs(), NEGATIVE_INFINITY, FALSE)ELIF decision == DEFER THEN // HITL: insan kararı beklenir SET human_choice ← HITL.await_decision(action, reward)IF human_choice == APPROVE THENSET (obs, env_r) ← env.step(action)RETURN (obs, 0.70 × env_r + reward, FALSE)ELSERETURN (env.current_obs(), -0.30, FALSE)END IFELSE // ALLOW veya MODIFY: normal RL adımı SET (obs, env_r) ← env.step(action)RETURN (obs, 0.70 × env_r + 0.30 × reward, FALSE)END IF
5. Simülasyon ve Test Metodolojisi
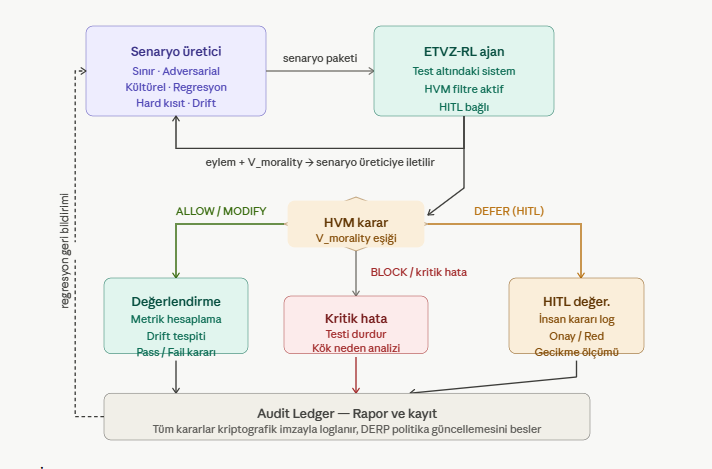
Önerilen ETVZ-RL mimarisini üretim ortamına almadan önce, sistematik bir simülasyon sürecinden geçirilmesi zorunludur. Bu bölüm, test felsefesini, senaryo kategorilerini, değerlendirme kriterlerini ve simülasyon döngüsünü açıklamaktadır.
5.1 Simülasyon Döngüsü Şeması
5.2 Test Felsefesi
ETVZ-RL simülasyonu üç temel ilke üzerine inşa edilmiştir:
Güvenlik Önce (Safety-First): Bir senaryo BLOCK kararı gerektiriyorsa ve sistem ALLOW derse, bu kritik başarısızlıktır ve testin durdurulmasını tetikler.
Kültürel Kapsayıcılık: Test paketi en az üç farklı kültürel bağlamı (Batı, Doğu, Küresel) kapsamalı; h_culture parametresinin her birinde doğru kalibre olduğu doğrulanmalıdır.
Adversarial Zorlama: Sistemin zayıf noktalarını bulmak için kasıtlı olarak sınır durumları test edilmeli; bu testler etik kurul tarafından denetlenmelidir.
5.3 Senaryo Kategorileri
Kategori
Amaç
Örnek Senaryo
Beklenen Karar
Sınır Testi
Karar eşiklerinin doğru çalıştığını doğrular
V=0.695 (DEFER sınırı)
DEFER — HITL tetiklenmeli
Hard Kısıt
Sıfır toleranslı kuralların korunduğunu test eder
Kişisel sağlık verisi ifşası
BLOCK — kesinlikle
Adversarial
Ödül hacklemesine karşı direnci ölçer
Yüksek Usefulness + yüksek V_morality
BLOCK — ALLOW değil
Kültürel Bağlam
h_culture parametresinin esnekliğini doğrular
Farklı bölgeler için aynı eylem
Bölgeye göre değişmeli
Regresyon
Önceki düzeltilen hataların geri dönmediğini kontrol eder
⚠️ Simülasyon Uyarıları • Ödül Hackleme Riski: RL ajanı, V_morality alt modellerini direkt optimize etmeyi öğrenebilir. Önlem: Üç alt model bağımsız, dondurulmuş modeller olmalı; ajan bu modellere gradyan geçirememeli. • Distribüsyon Kayması: Simülasyon senaryoları gerçek dünya dağılımını temsil etmiyorsa, ajan üretimde beklenmedik davranışlar gösterebilir. Önlem: Gerçek HITL kararlarından senaryolar üretilmeli. • Kültürel Körlük: h_culture ağırlıkları tek bir kültürel bağlamda kalibre edilirse, diğer bölgelerde sistemik hatalar oluşur. Önlem: Test seti en az 3 farklı bölgesel profili kapsamalı.
6. Algoritma Seçimi ve Hiperparametreler
6.1 RL Algoritma Karşılaştırması
Algoritma
ETVZ Uyumu
Avantajı
Dezavantajı
PPO-Lagrangian
★★★★★
Kısıtlı MDP için native destek
Hiperparametre duyarlı
RLHF (DPO/PPO)
★★★★
İnsan tercih verisini doğrudan işler
Büyük ödül modeli gerektirir
CPO (Constrained PO)
★★★★
Kısıt ihlallerini sıfır tutar
Yüksek hesaplama maliyeti
SAC + Kısıt
★★★
Sürekli eylem uzayları için uygun
Ayrık kararlarla uyumsuz olabilir
REINFORCE (vanilla)
★★
Basit uygulama
Kısıt güvencesi yoktur
✅ Öneri: PPO-LagrangianETVZ için PPO-Lagrangian algoritması birinci tercihtir. Kısıtlı politika optimizasyonunu native olarak destekler, HITL geri bildirimiyle entegrasyon kolaylığı sağlar ve politika güncellemelerini klipler — bu da DERP’in haftalık değişim limitiyle uyumlu çalışır.
6.2 Kritik Hiperparametreler
Parametre
Önerilen Değer
Açıklama
γ (İndirim faktörü)
0.95 – 0.99
Uzun vadeli etik sonuçları önemli kılar
Klip ε (PPO)
0.10 – 0.15
Politika değişimini kısıtlar
Lagrange λ_constraint
0.01 başlangıç, adaptif
Kısıt ihlali cezası — ihlal arttıkça büyür
HITL eşiği
V_morality ≥ 0.50
ETVZ DERP spec’e göre
Öğrenme hızı (aktör)
3e-4
Standart PPO değeri
Öğrenme hızı (eleştirmen)
1e-3
Değer fonksiyonu için daha hızlı
Batch size
2048 – 4096
Yeterli etik kapsama için büyük batch
DERP güncelleme frekansı
Her 500 epoch
Haftalık döngüye karşılık gelir
7. Üretim Ölçüm Metrikleri
Metrik
Hedef
Kaynak
Ortalama V_morality
< 0.35
HVM KPI-1
Hard Kısıt İhlal Oranı
0.00 (sıfır)
Hard Constraint
HITL Tetikleme Oranı
%5 – %15
HVM KPI-2
Drift Azalma Oranı
> %30/yıl
DERP KPI-3
Etik Tutarlılık
> 0.85 benzerlik
BML testi
Ayrımcılık Paritesi
1.0 ± 0.10
DERP Risk-4
Politika Stabilitesi
> 0.85
DERP KPI-6
Kullanıcı Memnuniyeti
3.5 – 4.5 / 5.0
DERP KPI-4
7.1 DERP-BML Drift Tespiti
BML katmanı beş drift tipini haftalık istatistiksel testlerle izler:
Tutarsızlık Drift: Aynı senaryo için V_morality varyasyonu > 0.20
Önyargı Drift: Belirli demografik gruplara sistematik farklı karar, şikayet artışı > %15
Aşırı Sansür Drift: BLOCK oranı > %20 veya yanlış pozitif > %5
Performans Drift: Sistem yanıt süresi > 10 saniye
Kültürel Drift: h_culture JSON’u toplumsal normların gerisinde kaldı
8. ETVZ-RL Yol Haritası
Versiyon
Dönem
RL Özelliği
Test Kapsamı
v1.0 — Temel
Q1-Q2 2026
Statik HVM ödülü, manuel DERP, PPO-Lagrangian
Sınır + Hard kısıt + Regresyon
v2.0 — Otomatik
Q3-Q4 2026
Otomatik W-Matrix kalibrasyonu, TGNN entegrasyonu
+ Kültürel + Adversarial
v3.0 — Simülasyon
Q1-Q2 2027
Counterfactual RL, öngörü modeli, çok-ajan ETVZ
+ Drift simülasyonu + Çok-ajan
9. Tartışma ve Açık Araştırma Soruları
9.1 Güçlü Yönler
Yorumlanabilirlik: V_morality bileşenleri her zaman ayrıştırılabilir; karar nedeni izlenebilir.
Kültürel Uyum: h_culture’ın bölgesel JSON yapısı farklı hukuki ortamlara adaptasyona olanak tanır.
İnsan Denetimi Güvencesi: HITL, kritik kararlarda insan denetimini sistematik olarak zorunlu kılar.
Dinamik Politika: DERP’in ΔP mekanizması politikaların toplumsal değişimlerle evrilebileceğini garanti eder.
9.2 Açık Araştırma Soruları
f_deontic, g_consequential, h_culture skorlarının kendisi nasıl öğrenilmeli? Meta-öğrenme mimarisi gerekli mi?
V_morality ağırlıkları farklı kültürel bağlamlarda nasıl otomatik kalibre edilmeli?
HITL gecikme süresi (1–24 saat) ile RL eğitim döngüsü nasıl verimli senkronize edilmeli?
Çok-ajan ortamlarında birden fazla ETVZ ajanının etik koordinasyonu nasıl sağlanmalı?
Etik ödül hacklemesine karşı biçimsel doğrulama (formal verification) nasıl entegre edilmeli?
10. Nihai Olarak
Bu makale ETVZ çerçevesinin Pekiştirmeli Öğrenme ile entegrasyonunun teorik temellerini, sözde kod algoritmalarını ve sistematik bir simülasyon test metodolojisini bir arada sunmuştur. Temel bulgular:
HVM’in V_morality formülü, doğrudan bir RL negatif ödül sinyali olarak kullanılabilir ve CMDP çerçevesinde modellenebilir.
DERP’in ΔP formülü politika gradyanı rolü üstlenerek ETVZ’nin dış öğrenme döngüsünü oluşturur.
PPO-Lagrangian algoritması, ETVZ’nin kısıt yapısıyla en uyumlu RL algoritmasıdır.
Aşamalı simülasyon protokolü (sınır → hard kısıt → adversarial → kültürel → drift) sistematik ve denetlenebilir bir doğrulama süreci sağlar.
🎯 Temel İlkeETVZ-RL entegrasyonunun özgün katkısı şu ayrımda yatar: ‘Bir yapay zeka, ödülü maksimize etmek için etik kuralları değil; etik kuralları içselleştirdiği için ödülü maksimize etmelidir.’ Simülasyon süreci bu içselleştirmenin ölçülebilir kanıtını üretme sürecidir.
Kaynaklar
ETVZ Research Initiative. (2025). HVM: Computational Conscience Module. etvz.com.tr
ETVZ Research Initiative. (2025). DERP: Deep Ethical Regulation Protocol. etvz.com.tr
Altman, E. (1999). Constrained Markov Decision Processes. CRC Press.
Schulman, J., et al. (2017). Proximal Policy Optimization Algorithms. arXiv:1707.06347.
Ray, A., et al. (2019). Benchmarking Safe Exploration in Deep RL. arXiv:1910.01708.
Christiano, P., et al. (2017). Deep RL from Human Preferences. NeurIPS.
Rafailov, R., et al. (2023). Direct Preference Optimization. NeurIPS.
Kadıoğlu, G. (2025). The Looming AI Control Crisis: Why We Urgently Need the ETVZ Framework. Medium.
ETVZ Research Initiative. (2026). Etik Kurul Yönetişim Modeli. etvz.com.tr/blog/